È possibile bloccare l’addestramento AI con robots.txt? La risposta richiede cautela. Google ha annunciato l’intenzione di supportare un segnale condiviso che permetta ai siti di esprimere una preferenza contraria all’uso dei contenuti per addestrare modelli generativi. Il meccanismo, però, non è un blocco tecnico universale e non è ancora uno standard IETF definitivo.
Questa guida chiarisce cosa prevede la proposta, come si distingue dalle regole dedicate ai crawler e quale rapporto avrebbe con Google-Extended. Tutte le informazioni sullo stato del progetto sono aggiornate al 5 novembre 2026.
Di cosa parlerò in questa pagina
Che cosa ha annunciato Google
Il 30 ottobre 2026 Google ha annunciato il progetto di supportare un controllo condiviso in robots.txt. L’obiettivo è consentire ai proprietari dei siti di dichiarare in un solo passaggio una preferenza relativa all’addestramento AI, potenzialmente interpretabile da più provider.
Google prevede di introdurre il supporto nel corso del 2027, ma non ha indicato una data precisa né pubblicato un elenco definitivo dei provider aderenti. La proposta nasce dai lavori AIPREF collegati all’Internet Engineering Task Force.
Cosa sappiamo
- La sintassi proposta riutilizza le regole già impiegate nei file
robots.txt. - Il controllo riguarda l’uso dei contenuti per l’addestramento di modelli generativi.
- Google ha dichiarato l’intenzione di supportarlo nel 2027.
- I controlli specifici dei singoli provider possono continuare a essere utilizzati.
Cosa resta da definire
- Al 5 novembre 2026 il documento è un Internet-Draft individuale, versione
-00, non uno standard IETF approvato. - Sintassi, precedenze e definizioni possono ancora cambiare.
- Non sono disponibili una data operativa precisa e un elenco definitivo dei provider che rispetteranno il segnale.
- La proposta potrebbe essere aggiornata, sostituita o abbandonata durante il percorso di standardizzazione.
Come funzionerebbe il controllo in robots.txt
Per esprimere la preferenza di non utilizzare i contenuti dell’intero sito nell’addestramento AI, la formula proposta è:
User-agent: __usage_ai-training
Disallow: /
__usage_ai-training non è l’identificativo di uno specifico crawler. È un token di policy: comunica una preferenza sull’impiego dei contenuti che sono stati recuperati. La sintassi usa le consuete direttive Disallow e Allow, senza introdurre nuove direttive nel protocollo.
Gestire directory diverse
La proposta consente di combinare Disallow e Allow applicando il criterio del percorso più specifico. Per esempio, il sito potrebbe escludere tutti i contenuti e autorizzare una directory come /press-kit/:
User-agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
In base alla formulazione attuale, questa configurazione esprimerebbe una preferenza favorevole all’addestramento per il percorso più specifico e contraria per il resto del sito. Poiché il draft può cambiare, la sintassi dovrà essere verificata sulla documentazione definitiva prima di un’implementazione operativa.
Crawling, indicizzazione e addestramento AI: le differenze
Il punto più importante per web agency, sviluppatori e titolari dei siti è distinguere quattro aspetti che spesso vengono sovrapposti:
| Ambito | Che cosa riguarda | Tipo di controllo |
|---|---|---|
| Crawling | L’accesso e il recupero delle risorse da parte di un bot. | Regole rivolte allo user agent dello specifico crawler. |
| Indicizzazione | La possibile presenza di una pagina nei risultati di ricerca. | Non coincide con il token proposto per l’addestramento. |
| Addestramento AI | Secondo la definizione attuale, l’uso dei contenuti per modificare i parametri appresi di un modello generativo. | Preferenza dichiarata tramite __usage_ai-training. |
| Uso nelle risposte AI | Il possibile utilizzo di un sito come fonte, anche con citazioni o link. | Dipende dalle regole e dai controlli previsti dai singoli provider. |
Il nuovo segnale, quindi, non impedisce necessariamente il crawling. Se si vuole limitare anche l’accesso, occorrono regole dedicate agli user agent dei singoli crawler. Non equivale neppure a una direttiva noindex e non deve essere presentato come una richiesta di esclusione dai risultati di ricerca.
L’ambito indicato dal draft è circoscritto all’addestramento dei modelli generativi. Non comprende automaticamente indicizzazione, ranking, retrieval, classificazione o qualsiasi altro impiego dell’intelligenza artificiale. La definizione attuale non include inoltre i modelli destinati esclusivamente a compiti non generativi.
Il rapporto con Google-Extended
Google-Extended è il controllo specifico che Google offre dal 2023. Secondo quanto dichiarato da Google, se non è presente una regola esplicita per Google-Extended, l’esclusione impostata attraverso __usage_ai-training sarà interpretata come disabilitazione di Google-Extended.
Questo non significa che i controlli specifici diventeranno inutili. Potranno continuare a funzionare e consentire eccezioni per singoli provider. Per prudenza, non è opportuno sostituire oggi Google-Extended o altri controlli già configurati con il solo token proposto.
Consentire Google-Extended può rendere un sito idoneo a essere usato come fonte nelle app Gemini. Non garantisce tuttavia che il sito venga selezionato, citato o collegato, né assicura traffico proveniente da tali applicazioni.
Anche un’eventuale configurazione che combini un divieto generale con un’autorizzazione specifica per Google-Extended dovrà essere verificata sulla futura documentazione operativa. Non è prudente considerare definitive regole non ancora pubblicate.
Che cosa non garantisce il segnale
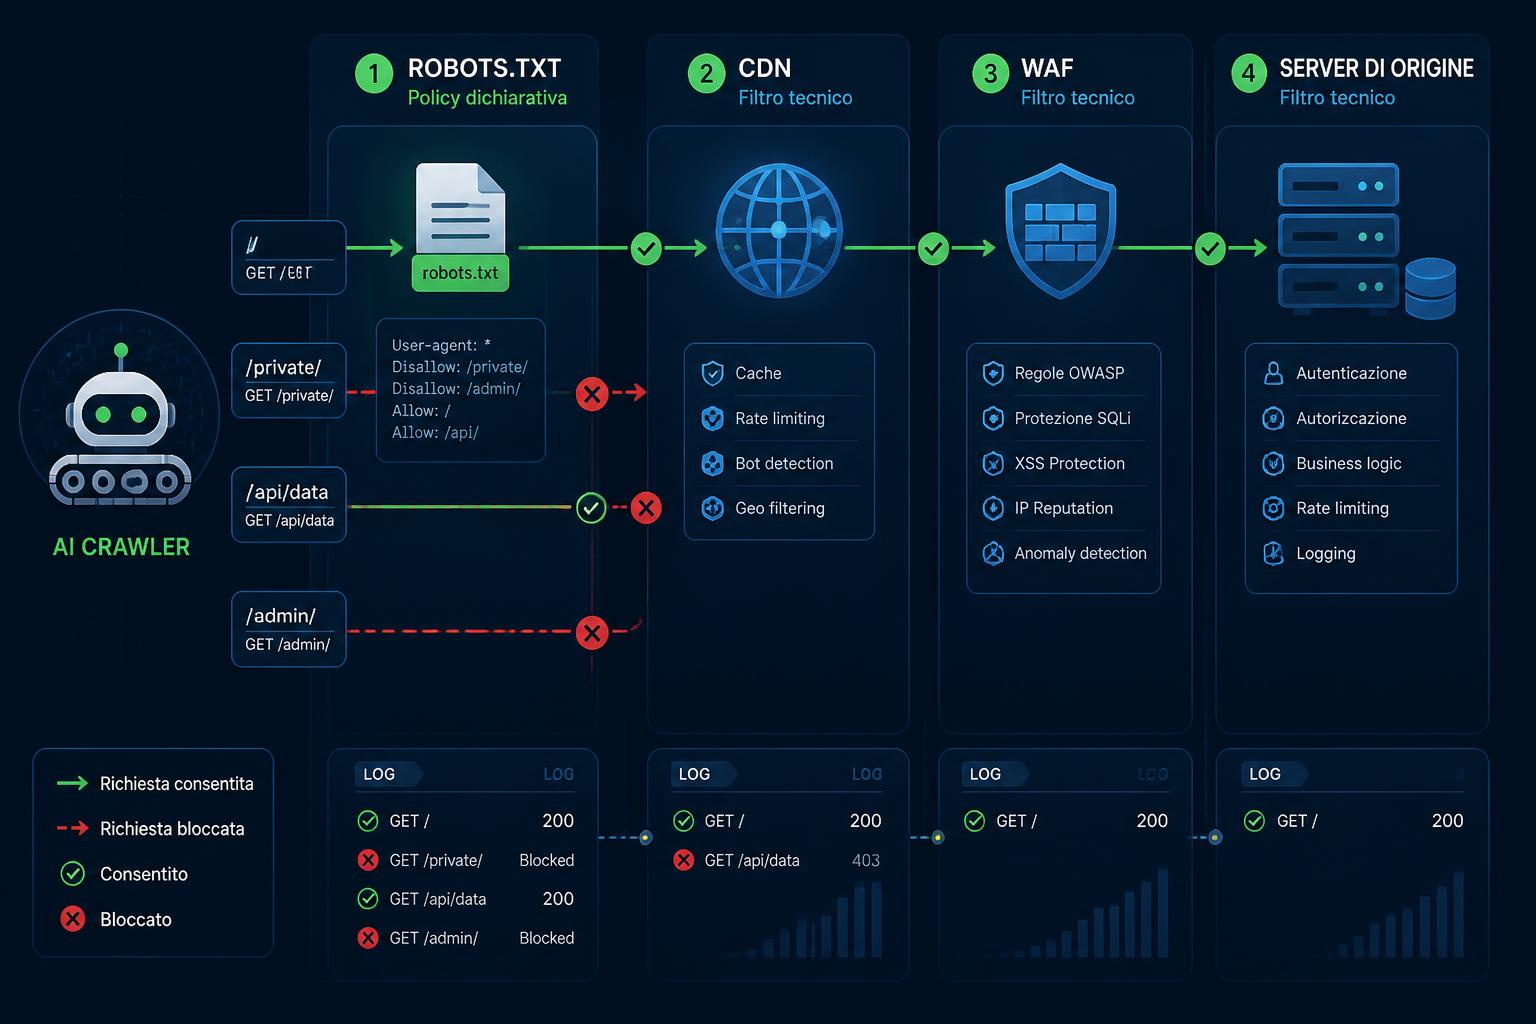
Il controllo è dichiarativo: la sua efficacia dipende dall’adozione e dal rispetto del protocollo da parte dei destinatari, oppure da eventuali obblighi applicabili. Il file robots.txt non costituisce una barriera tecnica contro operatori che non adottano o non rispettano il segnale.
- Non blocca automaticamente tutti i crawler AI.
- Non impedisce ogni possibile uso automatizzato dei contenuti.
- Non comporta automaticamente la cancellazione retroattiva di risorse già acquisite.
- Non sostituisce le regole di accesso dedicate ai singoli bot.
- Non offre da solo una garanzia completa di tutela del diritto d’autore.
- Non prevale necessariamente su eventuali accordi privati tra il titolare del sito e un provider.
Il draft collega la preferenza al file robots.txt disponibile al momento del recupero della risorsa. Da questa impostazione non deriva una rimozione retroattiva automatica dei contenuti già ottenuti.
Cosa possono fare oggi web agency e sviluppatori
In attesa del supporto operativo e di indicazioni definitive, agenzie e freelance possono preparare una gestione più ordinata delle policy dei clienti.
- Separare gli obiettivi: documentare distintamente indicizzazione, crawling dei bot AI, addestramento e uso dei contenuti nelle risposte AI.
- Mappare i controlli esistenti: verificare quali regole specifiche, compreso Google-Extended, sono già presenti.
- Centralizzare robots.txt: evitare modifiche non coordinate tra SEO, sviluppo, infrastruttura e marketing.
- Versionare la configurazione: registrare contenuto, data e motivazione di ogni modifica.
- Controllare i log server: monitorare gli accessi senza presumere che il nuovo token, da solo, impedisca il crawling.
- Seguire il draft IETF: verificare eventuali cambiamenti a sintassi, precedenze e definizioni.
- Riesaminare le impostazioni nel 2027: attendere tempi, test e documentazione operativa di Google prima di sostituire i controlli esistenti.
- Valutare il compromesso: discutere con il cliente il rapporto tra protezione dei contenuti e possibile visibilità nelle risposte AI, coinvolgendo un consulente legale quando necessario.
Un audit tecnico può includere l’analisi dei crawler, la definizione della policy, la configurazione versionata di robots.txt, il monitoraggio e una revisione periodica delle regole.
Il riferimento al Codice europeo GPAI
Il Codice europeo di buone pratiche per i modelli GPAI è volontario. Contempla l’impegno dei firmatari a rispettare robots.txt, le successive versioni IETF e altri protocolli leggibili dalle macchine impiegati per la riserva dei diritti.
Questo riferimento offre un contesto importante, ma non trasforma automaticamente una configurazione di robots.txt in una garanzia autonoma e completa di tutela del diritto d’autore. L’effetto del segnale deve essere valutato considerando adozione, rispetto del protocollo, eventuali obblighi applicabili e accordi esistenti.
Conclusioni
La proposta sostenuta da Google può semplificare il modo in cui i siti dichiarano una preferenza comune sull’addestramento AI. Non va però confusa con un blocco tecnico dei bot, con noindex o con una protezione universale dei contenuti.
Per web agency e sviluppatori, l’approccio più prudente consiste nel mantenere i controlli specifici già in uso, documentare separatamente ogni obiettivo e seguire l’evoluzione del draft prima di modificare le configurazioni operative.
Hai bisogno di un audit dei crawler o di una policy robots.txt centralizzata e versionata? Contattami per saperne di più.
Fonti di riferimento
- Google Search Central, “Supporting a shared AI training control for websites”, 30 ottobre 2026.
- Internet-Draft IETF collegato ai lavori AIPREF, versione individuale
-00, stato verificato al 5 novembre 2026. - Commissione europea, Codice di buone pratiche per i modelli GPAI.
AI Modified
Fonti
- Supporting a shared AI training control for websites (developers.google.com)
- draft-kelley-aipref-training-preference-signal-00 – Machine-Readable Training Preference Signal (datatracker.ietf.org)
- The General-Purpose AI Code of Practice | Shaping Europe’s digital future (digital-strategy.ec.europa.eu)
Domande frequenti
No. Il token proposto esprime una preferenza sull’uso dei contenuti recuperati per l’addestramento di modelli generativi. Per limitare l’accesso occorrono regole dedicate agli user agent dei singoli crawler.
__usage_ai-training è una policy condivisa proposta per l’addestramento AI. Google-Extended è un controllo specifico di Google. noindex riguarda invece la presenza di una risorsa nell’indice di ricerca e non equivale a una preferenza sull’addestramento.
La proposta consente di utilizzare Allow e Disallow per percorsi specifici, applicando la precedenza del match più specifico. La configurazione dovrà comunque essere verificata sul testo e sulla documentazione definitivi.
No. Al 5 novembre 2026 è ancora una proposta contenuta in un Internet-Draft individuale versione -00. Google prevede il supporto nel 2027, senza aver indicato una data precisa o un elenco definitivo dei provider aderenti.
Google dichiara che, in assenza di una regola esplicita per Google-Extended, interpreterà l’esclusione tramite il nuovo token come disabilitazione di Google-Extended. I controlli specifici potranno comunque continuare a essere usati.
No. Può rendere il sito idoneo a essere utilizzato come fonte nelle app Gemini, ma non garantisce selezione, citazioni, link o traffico.