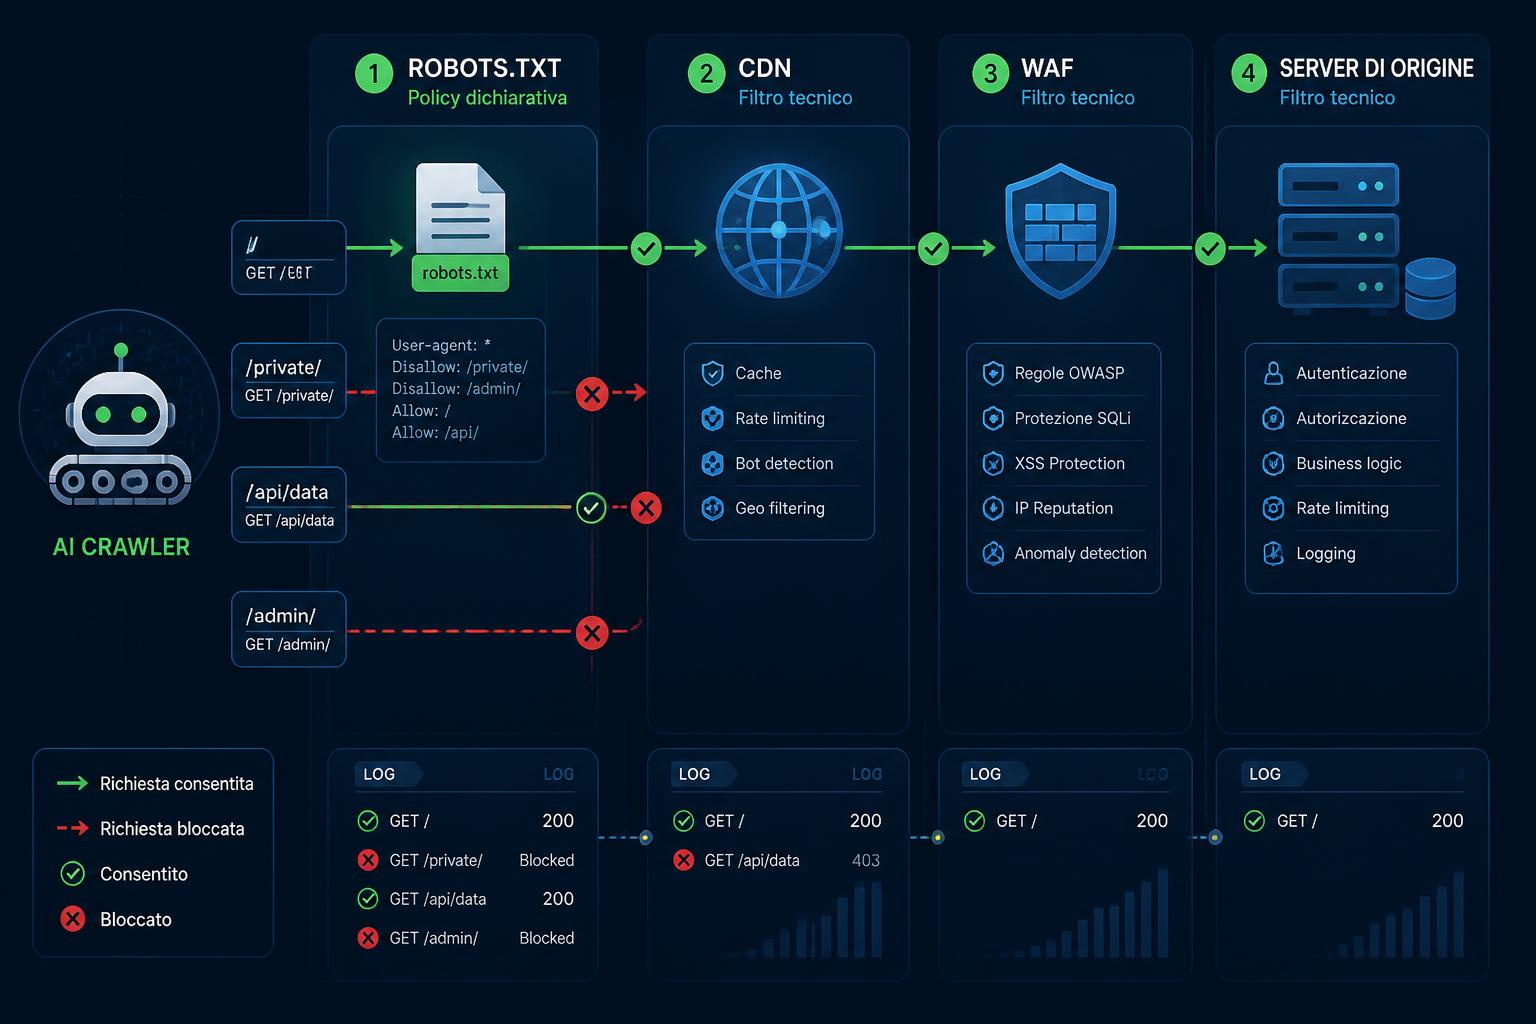
Robots.txt dichiara la policy; CDN, WAF e server la fanno rispettare. Questa distinzione è il punto di partenza per decidere come bloccare i crawler AI senza confondere una richiesta rivolta ai bot con una barriera tecnica.
Prima di configurare qualsiasi regola, però, bisogna stabilire quale attività si vuole limitare. La definizione generica di “crawler AI” può comprendere bot legati al training, sistemi di ricerca AI, agenti attivati dagli utenti e attività di scraping non dichiarato. Trattarli tutti nello stesso modo può produrre conseguenze non desiderate senza fermare i crawler non conformi.
Di cosa parlerò in questa pagina
Prima di bloccare: definire attività e obiettivo
La domanda corretta non è soltanto “dove posso applicare il blocco?”, ma anche “quale attività voglio bloccare e perché?”. Gli obiettivi più comuni possono essere:
- limitare il possibile utilizzo dei contenuti per il training;
- ridurre il carico generato dalle richieste automatiche;
- contrastare lo scraping non autorizzato o non dichiarato;
- impedire l’accesso a specifici percorsi;
- rinunciare consapevolmente alla potenziale reperibilità e citabilità nelle risposte AI.
Questi obiettivi richiedono controlli diversi. Una direttiva in robots.txt può comunicare una preferenza ai crawler conformi, ma non protegge contenuti riservati e non garantisce né il rifiuto della richiesta né una riduzione del carico sul server.
Robots.txt: una policy, non una barriera tecnica
Il file robots.txt consente di pubblicare direttive differenziate per user-agent e percorso. È quindi utile per rendere esplicita una policy di scansione, soprattutto nei confronti dei bot che dichiarano la propria identità e rispettano le indicazioni ricevute.
Il suo limite è strutturale: l’applicazione della direttiva dipende dalla collaborazione del crawler. Un bot può ignorare il file, cambiare identificazione oppure dichiarare uno user-agent non corrispondente alla propria identità reale.
Di conseguenza, robots.txt:
- non impedisce tecnicamente di richiedere una risorsa;
- non è uno strumento per proteggere contenuti riservati;
- non garantisce che le richieste non raggiungano l’hosting;
- non garantisce una diminuzione del consumo di risorse;
- non permette di verificare l’identità reale basandosi solo sul nome dichiarato dal client.
Indicizzazione e direttiva noindex
Secondo la documentazione richiamata dalla fonte, una pagina non consentita tramite robots.txt potrebbe comunque comparire come titolo e link qualora fosse scoperta attraverso fonti esterne. Inoltre, perché una direttiva noindex possa essere letta, il crawler deve poter accedere alla pagina che la contiene.
Bloccare la scansione e richiedere la lettura di una direttiva presente nella pagina sono quindi azioni da valutare con attenzione: una configurazione può impedire al crawler di vedere proprio l’indicazione che dovrebbe elaborare.
CDN e WAF: bloccare prima dell’origine
CDN e WAF possono intercettare le richieste prima che raggiungano hosting, CMS o applicazione. Per questo sono particolarmente utili quando l’obiettivo non è soltanto dichiarare una policy, ma fermare il traffico a monte e proteggere meglio le risorse dell’origine.
Questi livelli possono offrire gestione centralizzata, registrazione degli eventi e regole aggiornabili. Un WAF può inoltre valutare più segnali, tra cui:
- user-agent dichiarato;
- indirizzo IP o ASN;
- percorso richiesto;
- Paese di provenienza;
- frequenza delle richieste;
- firma attribuita al bot;
- impronta del client.
Combinare più segnali permette controlli più granulari rispetto a una regola fondata esclusivamente sullo user-agent. Quest’ultima rimane facilmente eludibile, perché il valore può essere falsificato.
Proteggere anche l’origine
La CDN può filtrare soltanto il traffico che la attraversa. Se l’indirizzo IP dell’origine rimane direttamente raggiungibile, un client potrebbe aggirare il livello CDN e contattare l’hosting. La protezione dell’origine è quindi parte della configurazione e non un dettaglio separato.
Il caso Cloudflare
Cloudflare distingue tra Managed robots.txt, che opera sul piano dichiarativo, e Block AI bots, che applica una regola gestita di blocco. La distinzione riflette i due approcci: comunicare una policy oppure rifiutare tecnicamente le richieste intercettate.
Blocco server: effettivo, ma applicato all’origine
Un blocco può essere configurato anche su Nginx, Apache, middleware o framework applicativi. In questo caso l’infrastruttura di origine può restituire un rifiuto effettivo, per esempio una risposta 403 Forbidden.
Il server permette di definire regole specifiche per l’applicazione e può essere utilizzato come fallback rispetto ai controlli a monte. Presenta tuttavia due differenze rilevanti rispetto a CDN e WAF:
- la richiesta ha già raggiunto l’hosting e consumato almeno una parte delle sue risorse;
- le regole richiedono manutenzione diretta sull’infrastruttura o sull’applicazione.
Il blocco server è dunque effettivo, ma non è equivalente a un filtro applicato prima dell’origine.
GPTBot e OAI-SearchBot: perché non tutti i crawler hanno lo stesso ruolo
La distinzione documentata da OpenAI tra GPTBot e OAI-SearchBot mostra perché “crawler AI” non sia una categoria operativa unica.
- GPTBot è associato al possibile utilizzo dei contenuti per il training.
- OAI-SearchBot è associato alla reperibilità e alla citabilità dei contenuti nella ricerca di ChatGPT.
È quindi possibile esprimere in robots.txt una preferenza che blocchi GPTBot e consenta OAI-SearchBot. Questa configurazione comunica una policy selettiva ai crawler conformi, ma non costituisce da sola una barriera tecnica.
La separazione tra i due bot aiuta anche a chiarire un possibile compromesso: limitare il crawler associato al training non equivale necessariamente a rifiutare quello legato alla ricerca. Allo stesso modo, questi crawler non devono essere automaticamente equiparati agli agenti attivati dagli utenti o allo scraping non dichiarato.
Confronto tra robots.txt, CDN, WAF e server
| Livello | Funzione principale | Protezione dell’origine | Limite principale |
|---|---|---|---|
| Robots.txt | Dichiara una policy per user-agent e percorsi | Non impedisce tecnicamente le richieste | Dipende dalla collaborazione del crawler |
| CDN | Intercetta il traffico prima dell’hosting | Sì, per il traffico che attraversa la CDN | L’origine deve essere protetta dagli accessi diretti |
| WAF | Applica regole usando più segnali | Può fermare le richieste prima dell’origine | Le regole basate solo sullo user-agent sono eludibili |
| Server | Restituisce un rifiuto effettivo e applica regole specifiche | Il blocco avviene dopo l’arrivo della richiesta | Consuma risorse dell’origine e richiede manutenzione diretta |
Strategia stratificata: dalla policy al monitoraggio
I fatti documentati mostrano capacità e limiti dei diversi livelli. La strategia stratificata è invece una raccomandazione operativa derivata da questo confronto: non rappresenta una garanzia assoluta contro ogni crawler.
Per web agency, digital agency e professionisti, un processo prudente può seguire questi passaggi:
- Classificare i crawler per funzione. Distinguere training, ricerca AI, agenti e scraping anziché applicare automaticamente un blocco globale.
- Definire una policy selettiva. Stabilire quali bot o percorsi consentire e quali limitare in base all’obiettivo.
- Pubblicare la policy in robots.txt. In questo modo i crawler conformi possono leggerla e rispettarla.
- Applicare il blocco su CDN o WAF quando deve essere effettivo a monte. Se necessario, combinare più segnali invece di affidarsi soltanto allo user-agent.
- Proteggere l’origine. Evitare che il traffico possa aggirare la CDN contattando direttamente l’hosting.
- Usare il server come fallback o per esigenze applicative. Considerare che le richieste raggiungeranno comunque l’origine.
- Iniziare in modalità log, quando disponibile. Osservare richieste, risposte 403 e referral prima di rendere definitivo il blocco.
- Rivedere periodicamente la configurazione. User-agent, classificazioni dei provider e comportamenti dei crawler possono cambiare.
Limiti e conseguenze da valutare
Bloccare indiscriminatamente tutti i bot associati all’AI non è sempre una scelta vantaggiosa. Potrebbe ridurre opportunità di citazione, visibilità o traffico referral senza fermare bot che ignorano le policy o falsificano la propria identità.
Gli effetti sulla visibilità nelle risposte AI sono variabili e non possono essere garantiti in anticipo. Anche il blocco di un crawler associato al training agisce sulle richieste successive: non implica la rimozione di contenuti eventualmente già acquisiti.
La decisione dovrebbe quindi bilanciare:
- protezione delle risorse infrastrutturali;
- controllo desiderato sull’accesso ai contenuti;
- manutenzione richiesta dalle regole;
- possibili conseguenze sulla reperibilità;
- capacità effettiva di identificare il traffico.
Contattami per saperne di più.
Fonte principale: Search Engine Journal, “Should I Block AI Crawlers At Robots.txt Or Server Level?”. Funzioni e classificazioni dei servizi citati devono essere verificate sulle rispettive documentazioni aggiornate prima di modificare una configurazione in produzione.
Fonti
- Should I Block AI Crawlers At Robots.txt Or Server Level? – Ask An SEO via @sejournal, @HelenPollitt1 (www.searchenginejournal.com)
- Publishers and Developers – FAQ | OpenAI Help Center (help.openai.com)
- Custom rules · Cloudflare bot solutions docs (developers.cloudflare.com)
Domande frequenti
No, non costituisce un blocco tecnico. Comunica direttive che un crawler può rispettare o ignorare. Per rifiutare concretamente le richieste servono controlli applicati tramite CDN, WAF o server.
CDN e WAF possono intercettare il traffico prima che raggiunga l’origine. Il WAF può combinare più segnali per applicare regole granulari. Il server restituisce un rifiuto effettivo solo dopo aver ricevuto la richiesta e consumato almeno parte delle proprie risorse.
Sì, è possibile esprimere questa preferenza tramite direttive distinte in robots.txt. GPTBot è associato al possibile utilizzo per il training, mentre OAI-SearchBot è legato alla ricerca e alla citabilità in ChatGPT. La direttiva resta però dipendente dalla collaborazione del crawler.
Non contro ogni forma di elusione. Lo user-agent è un valore dichiarato dal client e può essere falsificato o modificato. Un WAF può rafforzare il controllo combinandolo con altri segnali, senza che ciò costituisca una garanzia assoluta.
È possibile, soprattutto quando il blocco coinvolge crawler associati alla ricerca e alla citabilità. Gli effetti reali su visibilità e traffico referral sono variabili; per questo è preferibile una policy selettiva accompagnata dal monitoraggio.
Non necessariamente. Bloccare oggi un crawler associato al training non implica la rimozione di contenuti eventualmente acquisiti in precedenza.
La configurazione più adatta dipende dall’attività da limitare, dall’architettura del sito e dal livello al quale si vuole fermare la richiesta. Posso supportare web agency e professionisti nella classificazione dei crawler, nella definizione della policy e nell’applicazione di controlli selettivi su robots.txt, CDN, WAF e server.