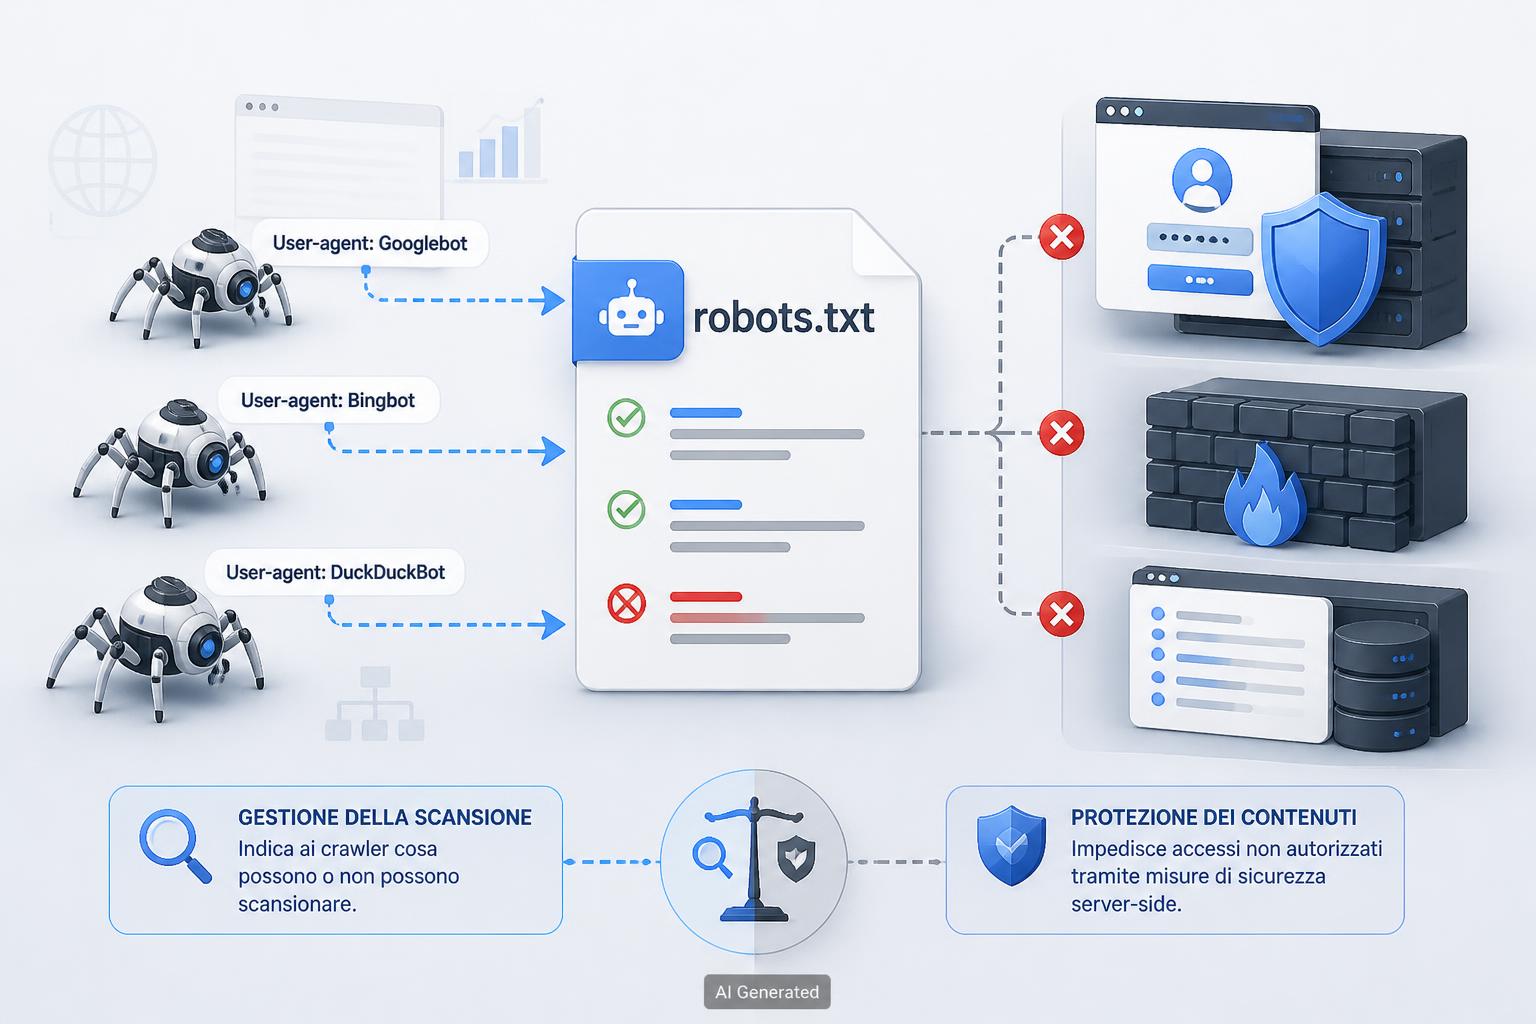
Il file robots.txt è utile per gestire il comportamento dei crawler identificabili e collaborativi, ma non è una barriera universale contro l’intelligenza artificiale. La distinzione fondamentale è semplice: robots.txt chiede a uno specifico crawler di non accedere a determinati URL. Non impedisce materialmente le richieste e non controlla automaticamente come un contenuto verrà usato dopo essere stato acquisito.
Per web agency, digital agency e professionisti, configurare correttamente robots.txt e intelligenza artificiale significa quindi separare tre livelli: lo standard del Robots Exclusion Protocol, i controlli proprietari dei singoli provider e le misure server-side necessarie per proteggere realmente file e aree riservate.
Di cosa parlerò in questa pagina
Robots.txt non è un interruttore anti-AI
Robots.txt comunica preferenze di scansione. Attraverso regole associate a uno user-agent è possibile chiedere a un crawler conforme di non visitare determinati percorsi oppure di consentirne l’accesso.
Questo meccanismo ha però limiti precisi:
- regola il crawling conforme, non l’uso successivo dei contenuti;
- dipende dalla corretta identificazione e dalla collaborazione del crawler;
- non tutti i bot rispettano le indicazioni;
- non impedisce tecnicamente di effettuare una richiesta;
- non sostituisce autenticazione, autorizzazioni o altri controlli di sicurezza.
Per questo non è corretto affermare che robots.txt “blocca l’intelligenza artificiale”. Può comunicare preferenze a specifici crawler, purché questi riconoscano e rispettino le regole.
Che cosa stabilisce RFC 9309
RFC 9309, pubblicato dall’IETF nel settembre 2022, definisce il Robots Exclusion Protocol. Il protocollo permette di impostare regole diverse per specifici user-agent e percorsi URL.
Lo standard non considera però robots.txt una forma di autorizzazione, un sistema di controllo degli accessi o una misura di sicurezza. Un percorso indicato con Disallow non diventa privato: la regola esprime una preferenza destinata ai crawler conformi.
Ne consegue che una direttiva inventata come:
No-AI-Training: true
non appartiene allo standard e può essere ignorata. Per comunicare preferenze relative alle attività AI occorre verificare se il singolo provider documenta uno user-agent o un controllo specifico.
Crawling, training e ricerca AI non sono la stessa cosa
Nel valutare una configurazione è importante non usare “AI” come etichetta per attività differenti. Crawling, training, grounding, indicizzazione, ricerca AI e accesso attivato dall’utente non sono equivalenti.
- Crawling: riguarda l’accesso agli URL da parte di un crawler.
- Training: riguarda il possibile uso dei contenuti per migliorare o addestrare modelli.
- Grounding: è una finalità distinta per la quale alcuni provider offrono controlli proprietari.
- Indicizzazione e ricerca AI: possono dipendere da crawler e regole differenti rispetto a quelli associati al training.
- Accesso attivato dall’utente: può essere gestito diversamente dalle scansioni automatiche.
Bloccare una di queste attività non implica necessariamente bloccare tutte le altre. Allo stesso modo, autorizzare un crawler destinato alla ricerca non significa automaticamente autorizzare ogni possibile impiego del contenuto.
Le modifiche introdotte oggi nel file robots.txt, inoltre, non eliminano copie o dati già acquisiti.
Google e OpenAI: controlli diversi per finalità diverse
Google-Extended
Google documenta Google-Extended come controllo per comunicare preferenze relative all’uso dei contenuti per futuri modelli Gemini e per alcune forme di grounding. Si tratta di un controllo proprietario di Google, non di una capacità nativa e universale prevista da RFC 9309.
La sua configurazione non deve quindi essere interpretata come una regola valida per tutti i sistemi AI o per qualsiasi crawler.
OAI-SearchBot, GPTBot e ChatGPT-User
OpenAI assegna ruoli distinti a diversi user-agent:
- OAI-SearchBot riguarda le funzionalità di ricerca di ChatGPT;
- GPTBot riguarda contenuti potenzialmente usati per migliorare o addestrare modelli;
- ChatGPT-User riguarda visite attivate dagli utenti.
Le relative impostazioni non devono essere considerate equivalenti. OpenAI segnala inoltre che robots.txt potrebbe non applicarsi alle visite di ChatGPT-User.
Quando OAI-SearchBot e GPTBot sono entrambi autorizzati, OpenAI può riutilizzare il risultato di una sola scansione. Prima di modificare il file è quindi opportuno controllare la documentazione ufficiale aggiornata del provider.
Esempio di configurazione per i crawler OpenAI
Il seguente esempio consente il crawler associato alla ricerca di ChatGPT e manifesta l’opt-out dal crawler associato al training:
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
Questa configurazione separa due obiettivi: mantenere la possibilità di presenza nella ricerca di ChatGPT e chiedere a GPTBot di non effettuare la scansione.
Non deve però essere presentata come un blocco universale dell’AI, come una protezione tecnica dei contenuti o come una cancellazione retroattiva dei dati. È una configurazione riferita a user-agent specifici e al comportamento documentato dal provider.
Perché evitare blocchi generici
Una regola indiscriminata come:
User-agent: *
Disallow: /
può compromettere la visibilità del sito nei motori di ricerca e nelle funzioni AI basate sul web. Prima di applicare un blocco globale bisogna chiarire quale risultato si vuole ottenere.
Gli obiettivi possibili includono:
- mantenere la presenza nella ricerca AI;
- manifestare un opt-out dal training presso un provider specifico;
- ridurre il crawling;
- escludere determinate sezioni;
- proteggere contenuti realmente riservati.
Quest’ultimo obiettivo non può essere raggiunto con robots.txt. Elencare directory sensibili nel file può anzi renderne pubblicamente visibile l’esistenza a chi consulta le regole.
Come proteggere davvero i contenuti
Robots.txt non protegge file privati, documenti interni o aree riservate. Quando l’accesso deve essere realmente impedito, occorrono controlli server-side o applicativi adeguati al caso.
Le misure da valutare includono:
- autenticazione degli utenti;
- autorizzazioni applicative;
- paywall effettivi;
- firewall o Web Application Firewall;
- limitazione delle richieste;
- monitoraggio dei log.
Questi strumenti hanno una funzione diversa da robots.txt: non si limitano a comunicare una preferenza al crawler, ma intervengono sulla possibilità di accedere alle risorse o sulla gestione delle richieste.
Checklist per un audit robots.txt e AI
- Definire l’obiettivo: distinguere tra visibilità, training, riduzione del crawling, esclusione di sezioni e protezione dei contenuti.
- Inventariare i crawler: analizzare i log per capire quali user-agent stanno effettuando richieste.
- Verificare l’identità: controllare user-agent e IP attraverso la documentazione ufficiale dei provider.
- Separare le finalità: non trattare come equivalenti crawler destinati alla ricerca, al training o alle visite attivate dagli utenti.
- Controllare i conflitti SEO: valutare se le regole possono limitare motori di ricerca o funzioni basate sul web.
- Testare sintassi e percorsi: verificare le regole prima della pubblicazione.
- Proteggere le risorse riservate: usare autenticazione e controlli server-side, non robots.txt.
- Monitorare gli effetti: analizzare i log dopo ogni modifica.
- Riesaminare la configurazione: user-agent, documentazione e controlli proprietari possono cambiare.
Serve una strategia, non un blocco indiscriminato
Una corretta gestione di robots.txt richiede di bilanciare obiettivi SEO, presenza nelle funzioni di ricerca AI, preferenze relative al training e protezione server-side. Un audit tecnico permette di individuare i crawler presenti, verificare possibili conflitti e scegliere controlli coerenti con le reali esigenze del sito.
AI Modified
Fonti
- Google’s Illyes: Robots.txt Covers Crawling, Not AI Training via @sejournal, @MattGSouthern (www.searchenginejournal.com)
- RFC 9309 – Robots Exclusion Protocol (datatracker.ietf.org)
- Overview of OpenAI Crawlers (developers.openai.com)
Domande frequenti
Non in modo universale. Robots.txt può chiedere a uno specifico crawler conforme di non accedere a determinati URL. Non impedisce materialmente le richieste, non è rispettato da tutti i bot e non controlla automaticamente l’uso successivo dei contenuti.
Sono attività distinte. Il crawling riguarda l’accesso agli URL; il training riguarda il possibile impiego dei contenuti per migliorare o addestrare modelli. Grounding, indicizzazione, ricerca AI e accesso attivato dall’utente possono avere finalità e controlli differenti. Bloccare un’attività non implica necessariamente bloccare le altre.
Sono controlli o user-agent documentati da specifici provider. Google-Extended comunica preferenze relative ad alcuni usi dei contenuti da parte di Google. OAI-SearchBot è associato alla ricerca di ChatGPT, GPTBot a contenuti potenzialmente usati per migliorare o addestrare modelli e ChatGPT-User alle visite attivate dagli utenti.
Non fa parte di RFC 9309 e può essere ignorata. Le preferenze devono essere espresse attraverso i controlli effettivamente documentati dai singoli provider, senza considerarli standard universali.
Con misure come autenticazione, autorizzazioni applicative, paywall effettivi, firewall o WAF e limitazione delle richieste. I log permettono inoltre di monitorare crawler, richieste ed effetti delle configurazioni.
No. Le nuove regole non eliminano copie o dati acquisiti in precedenza.